AI收录优化怎么做:先看清它和SEO收录的四处差异,再改三条打法
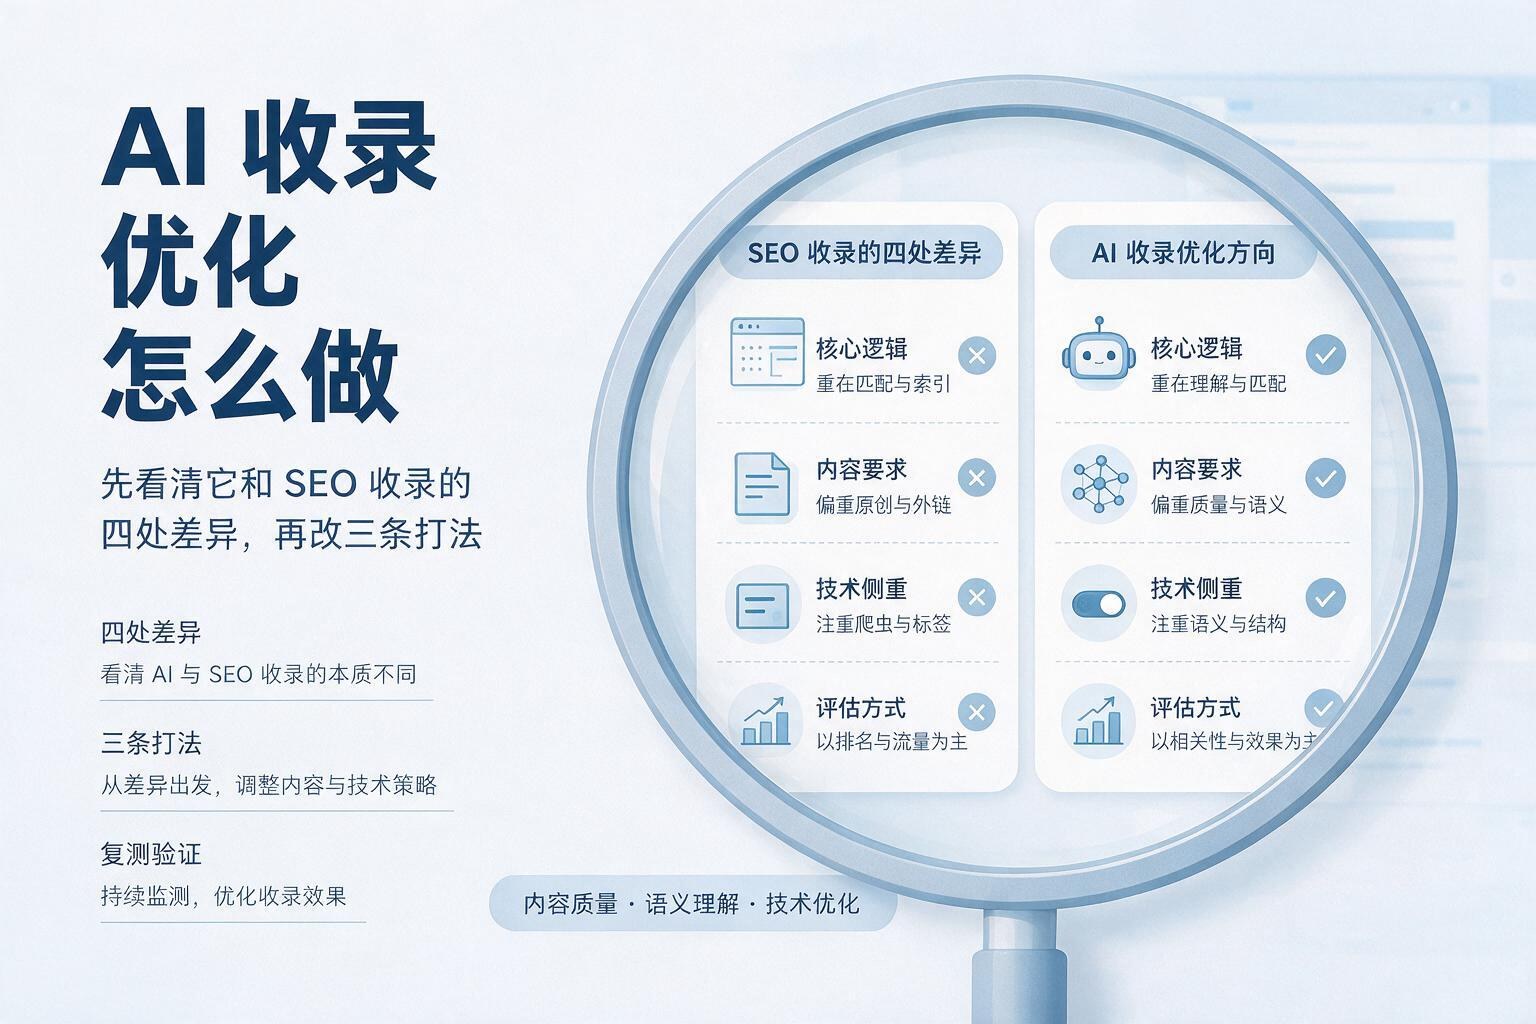
要点:两种收录不是一回事:SEO收录指页面被抓取后进入搜索引擎索引库,用户搜关键词时它能被检索出来;AI收录指内容被抓取、切片入库,在生成式回答里被检索与引用。引用是结果,不是收录本身,这一点先分清,后面的判断才不会跑偏。 链路也长得不一样。本文涉及AI收录和SEO收录到底差在哪:一张对照表说清、抓取主体与频次:为什么你的日志里AI爬虫表现不一样、索引切片与权重来源:内容要按「可被切走」来写。
- 内容进入 AI 侧索引时,先被切成片段再入库,所以写作要按「能被单独切走、单独引用」来组织,而不是按整页通读来安排。
- 旧SEO流程里,改一篇文章往往意味着新建页面、做内链、等收录;挪到AI侧,多数存量内容不必重发,改的是段落组织方式。
- 能主动做的只有一件事:把内容送进引擎的发现通道;至于切片、语义评估和是否被引用,提交管不到。
- 复测的做法是建一套固定口径、能每周重跑的检查,而不是去问一次 AI 看有没有提到你。
文章目录
AI收录优化怎么做?一句话:把页面从「给爬虫排队抓」改成「给模型切片取」。传统SEO收录关心的是爬虫来没来、页面进没进索引、关键词排第几;AI收录多了一道工序——内容被抓取后还要被
AI收录优化怎么做?一句话:把页面从「给爬虫排队抓」改成「给模型切片取」。传统SEO收录关心的是爬虫来没来、页面进没进索引、关键词排第几;AI收录多了一道工序——内容被抓取后还要被切成分块、做语义评估,才可能在回答里被引用。所以照搬旧流程常常出现「收录了但没被引用」。这篇按差异对照展开:先看抓取主体与频次、索引切片、权重来源三处不同,再把差异翻译成三条可落地的打法调整,最后给一套能自己复跑的复测方法。适合已经会做基础收录、想把打法往AI侧挪一步的运营和SEO同学。
AI收录和SEO收录到底差在哪:一张对照表说清
两种收录不是一回事:SEO收录指页面被抓取后进入搜索引擎索引库,用户搜关键词时它能被检索出来;AI收录指内容被抓取、切片入库,在生成式回答里被检索与引用。引用是结果,不是收录本身,这一点先分清,后面的判断才不会跑偏。
链路也长得不一样。SEO走的是抓取、索引、排序三段;AI在抓取之后多出切片与语义匹配两道环节,最后才落到引用。切片意味着你的内容会被拆成片段单独入库,一篇长文里哪一段能被取走,取决于那一段是否自成一个完整意思。据公开的 GEO 实践资料,切片常按标题层级与语义边界切分,段落过长容易被拦腰截断 。
| 对比项 | SEO收录 | AI收录 |
|---|---|---|
| 定义 | 页面进入索引库,可被关键词检索 | 内容被抓取、切片入库,可被生成式回答检索与引用 |
| 链路 | 抓取→索引→排序 | 抓取→切片→语义匹配→引用 |
| 判断标准 | 索引量、排名位次 | 是否被引用、引用时实体与口径是否正确 |
判断标准的分岔值得多说一句。SEO看的是索引进没进、排在第几位;AI看的是回答里有没有你、提到你时名字和数据对不对。索引量再大,如果被引用时钟点、单位、主体说错,这次引用反而是负分。
还有一点要提前摆明:抓取只是准入门槛。据一份 AI 爬虫日志排查记录,抓取和引用之间还隔着引擎侧的质量评估,抓到了不等于会被用 。所以看日志里爬虫来过就以为大功告成,是把准入门槛当成了终点。
这张表先立在这里,后面三处差异逐层展开,打法也就顺着它改。
抓取主体与频次:为什么你的日志里AI爬虫表现不一样
答案在于:AI 侧的抓取主体本来就比传统 SEO 多出一层,而且不同引擎的抓取逻辑不同,所以同一份日志里,机器人表现参差不齐是常态,不是异常。
先看抓取主体。传统搜索爬虫按一套排程扫站,AI 这边则是各家爬虫并存,且大致分成两类:一类偏向训练数据采集,一类偏向实时检索增强。有排查记录显示,PerplexityBot 三天抓了全站 3,471 次,而 GPTBot 只来了一次,差异正来自这两类引擎的抓取逻辑不同 。所以看到某个 AI 爬虫几乎不来,先别急着改内容,可能只是它不属于你期待的那一类。
频次上的落差更直观。据一份站点七日日志统计,爬虫请求 8,654 次,真人访问 247 次,约合每位读者对应 35 次机器人敲门,且 65% 的机器人请求没有标明身份 。这组数字只用来说明「机器人流量可以远高于真人」,它是单站样本,不能当行业基准。
要判断自家情况,走三步自查。其一,按 UA 分类,统计各 AI 爬虫的访问总量与高频页面,一条 grep 就能出周报 。其二,做正向 DNS 反查,别被伪造 UA 骗了,日志里的身份要验证来源才算数 。其三,口径要用源站全量日志或边缘日志;CDN 回源日志会因缓存命中丢掉请求与 UA,只能当参考 。
还有一点容易踩坑:Bot 防护常把 AI 爬虫当恶意流量拦掉。GPTBot 抓取频率不低,容易触发默认阈值,建议把已知 AI 爬虫从默认拦截阈值里放行 。放行之后再看日志,你拿到的频次数据才接近真实。
索引切片与权重来源:内容要按「可被切走」来写
内容进入 AI 侧索引时,先被切成片段再入库,所以写作要按「能被单独切走、单独引用」来组织,而不是按整页通读来安排。
切片方式决定段落会不会被腰斩。固定长度切分按字符或 Token 数硬切,实现简单,却容易把一句话从中间断开;结构感知切分按标题层级、段落、列表项切,尊重内容的自然边界;语义切分则用 Embedding 计算相邻句子的语义突变点,在话题转折处下刀 。三种方式里,后两种对写作者更友好。你能做的,是把每段写成语义完整的小单元,让切分算法无论从哪下刀,切出来的片段都站得住。
段落规范可以归纳成三条。其一,结论前置,段落首句直接给核心观点,后面再补限定条件、数据依据和场景说明,因为模型对段落开头的信息权重更高 。其二,一段一事,一个段落只承载一个事实,避免多主题混写导致切片后信息残缺 。其三,控制长度,不同来源给出的区间并不一致:60150 字 、80150 字 、4080 词 。取交集,按 80150 字执行更稳妥,超过这个范围就拆段。
权重来源也变了。传统 SEO 的权重更多来自外链数量与站点整体权重,AI 侧更看段落本身能不能独立被引用、实体是否明确、数据是否具体 。换句话说,一段话离开上下文还能读懂、还能被直接摘进答案,它的引用价值就更高。
落到结构动作上,标题用问句承接用户真实搜索问法,独立 FAQ 板块按用户问句搭问答对 ;列表项控制在 7 项以内,句子尽量带数字与单位,具体性会提升模型对内容的信任度 。
| 改写维度 | 旧写法 | 按切片改写 |
|---|---|---|
| 段落开头 | 铺垫背景再给结论 | 首句直接给结论 |
| 段落主题 | 一段讲多个点 | 一段只讲一件事 |
| 段落长度 | 长段连贯叙事 | 80~150 字,超出即拆 |
| 列表 | 十几项平铺 | 7 项以内 |
| 数字 | 「提升明显」 | 带数字与单位 |
按这张表逐段过一遍,改动量通常不大,但切片后的可引用性会明显不同。
三条打法调整:从旧SEO流程挪到AI侧
旧SEO流程里,改一篇文章往往意味着新建页面、做内链、等收录;挪到AI侧,多数存量内容不必重发,改的是段落组织方式。下面三条调整按落地顺序排,每条都给出验收信号,做完能看见变化。
其一,改写不重发:存量文章按「结论前置+一段一事」重排。 不用新建页面,把已有文章逐段过一遍:首句直接给结论,一段只讲一件事,段落控制在80~150字,超出就拆 。据阿里云开发者社区的内容创作说明,大模型切片时优先读取段落开头信息,铺垫式过渡会稀释信息密度 。客户能省的是建站与重发成本,能看到的是被切走的引用片段是否完整、是否带着结论一起出现。
其二,结构补齐:每篇补独立FAQ、统一实体称呼、给关键结论配数字与口径。 FAQ按用户真实问句搭问答对,实体称呼全文一致,同一对象不要一会儿叫全称一会儿叫简称 。结论尽量带数字和单位,列表项控制在7项以内,具体性会降低模型的抽取成本 。验收信号很直白:搜一个问句,看FAQ里的对应条目是否被直接命中,命中片段是否答到了问题本身。
其三,抓取通道理顺:先保证能被抓,再谈被引用。 检查robots与WAF有没有把AI爬虫当恶意流量拦掉,保留源站日志而不是只看CDN回源日志,按UA归类做访问周报 。据服务器日志的工程实践,抓取与引用之间还隔着引擎侧的质量评估,放行只是准入门槛 。验收信号是日志里目标爬虫的访问是否稳定、周与周之间有没有断档。
| 调整 | 改什么 | 客户省下什么 | 验收信号 |
|---|---|---|---|
| 改写不重发 | 段落重排,结论前置 | 新建页面与重发成本 | 引用片段是否完整 |
| 结构补齐 | FAQ、实体统一、数字口径 | 反复解释的沟通成本 | FAQ是否被直接命中 |
| 抓取通道 | 放行、源站日志、UA周报 | 排查抓取异常的工时 | 目标爬虫访问是否稳定 |
三条调整之间是递进关系:抓取通道不通,段落改得再好也进不了索引;段落切不干净,进了索引也抽不出可用的片段。效果受提问口径、内容信源与平台机制共同影响,按多轮趋势读比看单次结果更可靠。
AI收录怎么提交:能主动做的和只能等的
能主动做的只有一件事:把内容送进引擎的发现通道;至于切片、语义评估和是否被引用,提交管不到。
各搜索引擎站长平台是通用提交入口,先验证域名所有权——HTML 文件、DNS、CNAME 或 meta 标签任选其一,没验证接口会直接拒收。验证通过后按下面顺序走:
| 步骤 | 做什么 | 解决什么 | 验收信号 |
|---|---|---|---|
| 1 | 添加站点并完成所有权验证 | 拿到提交资格 | 后台显示验证通过 |
| 2 | 提交 Sitemap | 告知全站结构 | 地图状态为已读取 |
| 3 | 新稿走 API 主动推送 | 缩短发现时间 | 推送返回成功条数 |
| 4 | 查源站日志 | 确认抓取落地 | 目标爬虫访问稳定 |
API 主动推送比 Sitemap 快,适合挂在发布钩子上自动调用;百度单次推送上限 2000 条,日配额约 10 万,IndexNow 可让 Bing、Yandex 做到小时级抓取。这些是通道能力,不是收录承诺——提交只缩短爬虫发现新内容的时间,收不收、怎么切、引不引,仍由引擎侧决定。
AI 侧还有一层现实:部分 AI 搜索的内容来自其关联搜索平台的合规索引,提交要顺着这条索引链路走。这条线索只作参考,不同引擎的索引来源并不一致,别当成通用规律。
所以能主动做的是:验证站点、交 Sitemap、新稿推送、用日志确认抓取;只能等的是切片方式、语义评估和是否被引用。把前四步做扎实,等于把"被发现"这一段握在自己手里,后面的交给引擎。
效果复测:用一套可复跑的检查确认优化是否生效
复测的做法是建一套固定口径、能每周重跑的检查,而不是去问一次 AI 看有没有提到你。能否被引用,受提问方式、内容信源、平台机制共同影响,单次结果参考价值有限,多轮趋势更能说明问题。
观测拆成三层,各自看不同的东西。
其一,抓取层看日志。用源站全量日志或边缘日志做统计,CDN 回源日志会因缓存命中丢掉请求与 UA,只能当参考;同时做正向 DNS 反查,避免被伪造 UA 误导。按 UA 归类统计访问总量,再单独拉某个爬虫抓过哪些页面:
grep -oE "GPTBot|OAI-SearchBot|ClaudeBot|Bytespider" /var/log/nginx/access.log | sort | uniq -c | sort -rn
grep "Bytespider" /var/log/nginx/access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20
这两条命令分别给出各 AI 爬虫的访问总量和单爬虫的高频页面。把它按周跑一遍,看的是抓取是否稳定、重点页面有没有被反复访问。
其二,切片层抽查段落完整度。从被引用的回答里反查来源页面,看命中的是哪一段、该段是否被截断。段落长度有通行区间可参照,有实践者给出 80 到 150 个汉字的可独立引用片段范围,也有资料建议控制在 60 到 150 字。口径不一,你自己定一条并沿用即可,重点是一致。
其三,引用层按固定问句集定期提问。用 10 到 20 条真实用户问句做基线,每周复跑同一组问题,记录是否被引用、引用了哪段。用一张表回溯:
| 日期 | 问句 | 是否被引用 | 引用片段 | 对应页面与段落 |
|---|---|---|---|---|
| 周次 | 基线问句原文 | 是/否 | 摘录原文 | URL + 段落定位 |
这张表的价值在纵向对比:连续几周里抓取量是否稳住、片段是否更完整、被引用问句是否变多。能看到的正是抓取稳定性与引用片段完整度的变化;至于具体涨多少,各引擎口径不同,以你自己的连续记录为准。
结语
把这篇收成一张可执行清单:一、先看日志,按UA统计AI爬虫访问量与高频页面,做DNS反查防伪造,确认没被Bot防护拦掉;二、改内容结构,存量文章按结论前置、一段一事重排,段落控制在80150字,每篇补独立FAQ,关键结论带数字与口径;三、理顺提交通道,验证站点所有权、提交Sitemap、新稿走API推送,提交后回日志确认抓取;四、建复测表,固定1020条真实问句按周复跑,记录是否被引用与引用片段是否完整。四步里前三步是你能控制的,第四步是你能核对的。先跑两周基线,再决定往哪条打法加投入。
本文部分配图由 AI 生成。
常见问题
AI收录优化怎么做,和传统SEO收录要分开做吗?
不用完全分开,但要加两道工序。基础部分共用:站点可访问、Sitemap、提交入口、日志可查。差异在内容侧——SEO优化标题与关键词布局,AI侧要把段落改成结论前置、一段一事、80~150字可独立引用,并补独立FAQ。抓取侧也要多一步:确认AI爬虫没被Bot防护拦掉。做法上先共用底座,再在内容结构上做增量调整,不必另起一套站。
AI收录怎么提交,有没有官方入口?
通用做法是走各搜索引擎站长平台:先完成域名所有权验证,再提交Sitemap或用API主动推送,提交能缩短爬虫发现新内容的时间,但不等于一定收录。AI搜索侧,部分内容来自其关联搜索平台的合规索引,提交要顺着这条索引链路走。需要说清的是,提交解决「被发现」,切片与是否被引用由引擎侧评估决定,所以提交之后仍要用日志确认抓取是否到位。
段落写多长才容易被AI引用?
不同来源给的区间不完全一致:有建议60~150字,有建议80~150字,也有按40~80词给的。取交集按80~150字执行比较稳妥。比长度更重要的是结构:首句直接给结论,一段只讲一件事,关键结论带数字和单位。段落太长会增加模型抽取核心信息的成本,太短又可能被认为信息量不足。改完抽查几段被引用时的片段是否完整,比死守字数更有用。
把阅读中的方法用到您的品牌
从提问词和平台专属写手开始,组织品牌内容与后续监测。
免费注册