ai搜索排名榜单怎么看:拆来源、看口径、用趋势替代名次
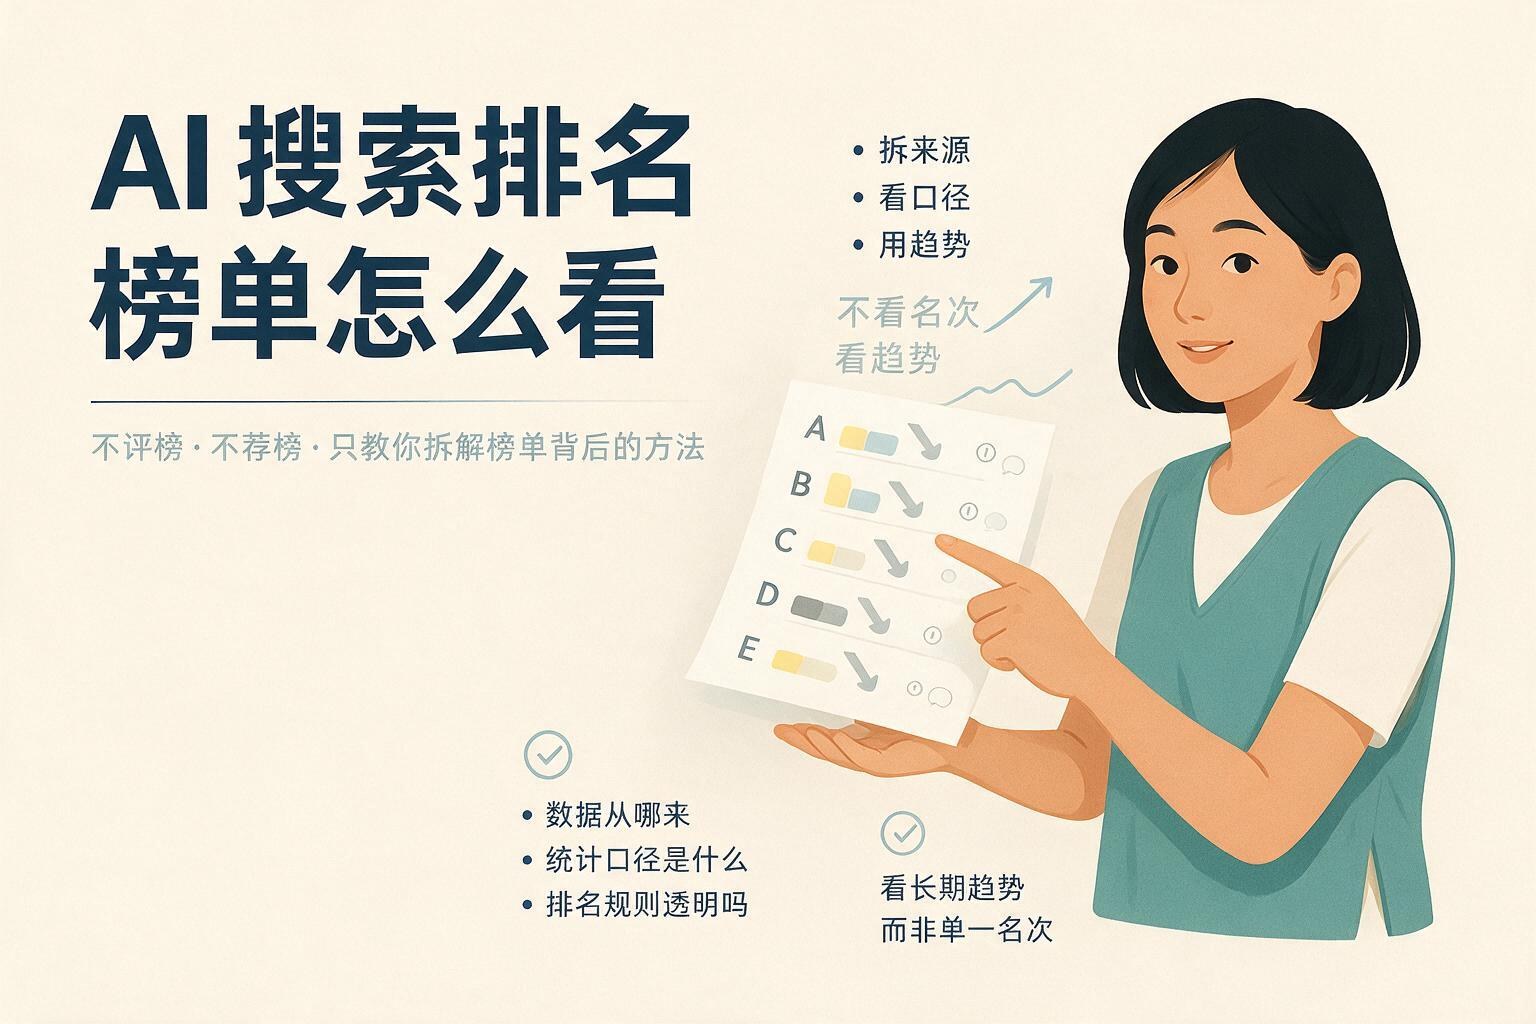
要点:拆开一份 AI 搜索排名榜单,先看它怎么把数据拿到手。常见路径就三种,各自能回答的问题不一样。 其一,人工提问采样。做法是按预设问句集,在多个平台逐条提问,记录品牌是否被提及、出现在答案的什么位置、引用了哪些来源。这类采集贴近真实提问场景,问句怎么设计、平台怎么选,都能对应到你自己的业务。本文涉及AI搜索排名榜单的数据通常从哪来、同一份榜单换个问法,结论为什么不一样、看趋势不看绝对值:把榜单当观测记录用。
- 拆开一份 AI 搜索排名榜单,先看它怎么把数据拿到手。
- 因为榜单统计的不是「你的品牌好不好」,而是「在它设定的问句集、平台和时间窗口里,你的品牌被提到了几次」。
- 读 AI 搜索排名榜单时,先要排除三类误读,否则后面的分析都容易跑偏。
- 与其纠结某份榜单准不准,不如自己动手记一份小样本,用自采数据去校验外部榜单——这是成本低、见效快的一条路。
看到一份 AI 搜索排名榜单,先别急着截图转发。这类榜单大多不是搜索引擎自然结果的排序,而是有人在特定时间、用特定问句、在特定平台上批量提问后整理出的观测记录。同一批问题换个平台、
看到一份 AI 搜索排名榜单,先别急着截图转发。这类榜单大多不是搜索引擎自然结果的排序,而是有人在特定时间、用特定问句、在特定平台上批量提问后整理出的观测记录。同一批问题换个平台、换种问法、隔一周再问,结论就可能变样。所以读榜的第一步不是看谁排前面,而是看它怎么来的:数据是人工提问、爬虫采集还是用户面板,问句集覆盖哪些场景,采样时间距今多久。把这三点对上,榜单才从结论变成参考。本文不评榜也不荐榜,只给一套拆解方法,让你能判断一份榜单值不值得看、哪些部分能信、哪些需要自己补记录。
AI搜索排名榜单的数据通常从哪来
拆开一份 AI 搜索排名榜单,先看它怎么把数据拿到手。常见路径就三种,各自能回答的问题不一样。
其一,人工提问采样。做法是按预设问句集,在多个平台逐条提问,记录品牌是否被提及、出现在答案的什么位置、引用了哪些来源。这类采集贴近真实提问场景,问句怎么设计、平台怎么选,都能对应到你自己的业务。代价也明显:样本量有限,一轮问下来人力成本不低,想高频复现就得持续投入。工程化追踪方案里,问题池要版本化管理、按品牌词与行业词分层,并记录平台、模型版本与时间戳 。
其二,爬虫或接口采集。批量抓取 AI 回答页面,或调用接口拿结果,适合做高频监控。麻烦在于页面结构会变、接口有限流、字段会漂移,数据连续性容易断。有开发者在对比两种路线时提到,爬虫拿的是“页面”,接口拿的是“口径”,页面随时会变 ;批量采集还可能遇到超时、限流或重复数据 。所以这类榜单要问一句:断档期间的数据怎么处理。
其三,用户面板与公开投票。来自用户点击、投票或问卷。这类数据反映的是关注度,和“AI 回答里谁被提到”不是一回事。以某大模型人气周榜为例,人气指数按站点当周点击量占池子总点击量的比例计算,千分制保留一位小数 ;它衡量的是访问热度,不是答案质量。
判断一份榜单值不值得参考,可以按三项核对:
| 核对项 | 看什么 | 缺了会怎样 |
|---|---|---|
| 采集方式 | 人工提问、爬虫还是用户投票 | 分不清数据性质,容易把热度当答案质量 |
| 平台清单 | 覆盖哪些 AI 搜索平台 | 结论只对部分平台成立,外推要谨慎 |
| 采样时间 | 采集窗口与更新周期 | 无法判断数据是否过期 |
三项里缺一项,参考权重就该往下调;三项都写清楚的,至少能让你知道自己在读什么。至于同一份榜单换个问法结论为何不同,要看下一节。
同一份榜单换个问法,结论为什么不一样
因为榜单统计的不是「你的品牌好不好」,而是「在它设定的问句集、平台和时间窗口里,你的品牌被提到了几次」。这三个变量任何一个变动,提及率就会跟着变,所以同一份榜单换个问法结论不同,是口径问题,不是数据出错。
其一,问句集的构成不同。一份榜单如果把品牌词、行业词、竞品词和场景长句混在一起统计,和只统计品牌词,算出来的提及率完全不是一回事。行业词和场景长句会把大量非品牌指向的回答纳入分母,品牌词的提及率被稀释;反过来只统计品牌词,分母小、命中集中,数字会显得好看。有工程实践把问题池按品牌词、行业词、竞品词分层管理,并给问题清单做版本记录 ,就是为了让不同期次的数字可比。拿到榜单,先找它的问句清单长什么样。
其二,平台不同,答案来源和呈现方式也不同。同一句问题,有的平台偏信息流式的答案位,有的平台偏深度推理加联网搜索 ,回答里引用了哪些页面、把品牌放在第几段,都会随平台机制走。一份只覆盖两三个平台的榜单,结论外推到其他平台要谨慎;平台清单越短,参考时越要看清它到底测了谁。
其三,时间窗口不同。AI 回答由模型在检索到的内容上生成,本身带有随机性,同一问题多轮提问结果就会有波动 。采集窗口隔了一周、模型版本换了一次,数字都可能挪位。榜单如果不写采样时间和更新周期,你无法判断读到的是哪一版世界。
对齐方法不复杂,拿到榜单按三步走:
| 对齐项 | 具体做法 | 重合度低时怎么办 |
|---|---|---|
| 问句集 | 找榜单的问题清单,和自己的业务问句比对 | 只借用重合部分,其余不套结论 |
| 平台 | 看覆盖平台与自家客户常用平台是否一致 | 把结论限定在已覆盖平台内 |
| 时间 | 看采样窗口与更新周期 | 过期数据只作历史参照 |
三项里重合度低,就别把榜单名次直接搬进汇报;重合度高的部分,可以拿来当自己观测记录的对照。至于怎么把榜单当观测记录用、而不是当结论用,下一节展开。
看趋势不看绝对值:把榜单当观测记录用
单次名次能说明的问题很有限。AI 搜索的回答由模型在检索内容上即时生成,天然带着随机性,同一句提问换个时间再问,措辞和提及顺序都可能变 。所以与其盯住某一次排到第几位,不如把它当成一条观测记录,看连续几周里提及率、引用来源、出现位置往哪个方向走。据腾讯云开发者社区一篇追踪实践文章的说法,同一问题在多个平台、多轮提问下的结果差异,本身就是值得分析的信息 。
要让它变成可比较的记录,字段不必多,但每次都得一致。建议固定七项:
| 字段 | 记录内容 |
|---|---|
| 提问日期 | 精确到日,便于对齐周次 |
| 平台名称 | 同一问句在哪些平台跑过 |
| 问句原文 | 一字不改,保证可比 |
| 品牌是否被提及 | 是/否,二值判断 |
| 提及位置 | 开头、中段、末尾或未出现 |
| 引用来源 | 回答里挂出的链接或站点 |
| 回答摘要 | 两三句概括,留作回溯 |
频率上按周或双周固定采样,问句集版本保持不变。中途新增的问句单独标记、单独成组,别和旧问句混在一张表里比,否则趋势线会被版本切换带偏。这一点和工程化追踪里的“问题池版本化”思路一致:问题清单要记录新增与失效,才谈得上可比 。
读法上,把同一问句在多个平台的结果并排摆开。哪些平台稳定提到你,哪些平台始终不出现,这比追一个单一名次更有决策价值。前者说明内容在这类平台的信源里站住了,后者提示该去补哪类内容。名次会跳,趋势不会天天翻脸。
需要提醒的是,趋势判断受提问口径、内容信源、平台机制共同影响,按多轮变化读比看单点更可靠。
三种常见误读,读榜时先排除
读 AI 搜索排名榜单时,先要排除三类误读,否则后面的分析都容易跑偏。
其一,把榜单名次当成搜索结果的真实排序。AI 搜索没有传统网页排名那种确定位次,回答由大模型在检索内容上综合生成,本身带有随机性,同一问题多轮提问结果都可能不同 。榜单上的名次,反映的是特定问句集下品牌被提及的情况,是一份观测记录,不是平台内部的固定排序。看到"某某排第几",先把它读成"在这批问句里它被提到的次数较多"。
其二,把不同口径的榜单拼在一起比较。问句集、平台、统计周期只要有一项不同,两份榜单的数字就不能直接对照。一份按周采样、覆盖若干平台的提及统计,和一份按月更新、靠投票与大数据筛选得出的名单,衡量的是两回事 。把两边的名次并排贴出来做涨幅分析,结论往往站不住。
其三,把关注度榜单当成答案质量榜单。按点击量或投票计算的指数,衡量的是热度,不是 AI 回答里的推荐质量。比如有榜单把人气指数定义为站点当周点击量占池子总点击量的比例,再乘千分制系数 ;这类数字说明谁被看得多,不说明谁在回答里被推荐得好。拿它判断内容质量,方向就错了。
排除方法可以落成两个问题。读榜时先问"它统计的是什么"——是提及、引用、点击还是投票;再问"它怎么统计的"——问句集怎么定、覆盖哪些平台、周期多长。两个问题答不上来,这份榜单就只当线索看,别当结论用。
| 误读 | 表面现象 | 实际统计的是什么 | 读榜时的处理 |
|---|---|---|---|
| 名次等于真实排序 | 榜单给出明确位次 | 特定问句集下的提及情况 | 读成提及频次,不读成平台排序 |
| 跨口径直接比较 | 两份榜单数字并列 | 问句集、平台、周期各不相同 | 先对齐三要素,对不齐就不比 |
| 关注度等于质量 | 指数高、排名靠前 | 点击量或投票折算的热度 | 只当热度参考,不判断回答质量 |
说到底,榜单是别人按某套口径采出来的切片。切片有用,但不能替代你自己对问句、平台和时间的记录。
自建记录比盲信榜单更可靠
与其纠结某份榜单准不准,不如自己动手记一份小样本,用自采数据去校验外部榜单——这是成本低、见效快的一条路。做法不复杂,关键在起步范围和记录纪律。
其一,起步范围收窄。先挑 10 到 20 条与自己业务直接相关的问句,覆盖三类:品牌词(含自家与主要竞品名称)、品类词(客户会怎么描述这类产品)、场景长句(带着具体需求去问的完整句子)。一开始不必铺大词库,问句越多,维护成本越高,反而容易半途而废。
其二,平台固定采样。选 2 到 3 个目标客户常用的 AI 搜索平台,固定下来连续观察,比如豆包、DeepSeek、腾讯元宝、通义千问等均可作为采样对象 。平台换得太勤,数据就失去可比性——同一问句在不同平台的回答逻辑本就不一样,混在一起记等于白记 。
其三,工具辅助但不替代判断。可以用表格手工记录,也可以用现成的 AI 搜索排名查询工具做批量提问和结构化整理。工具负责采集和归类,人负责判断问句集是否合理、哪些回答值得细看。记录字段建议至少包含:问句、平台、采样日期、是否提及品牌、提及位置、引用来源。
其四,用一个月的数据做校验。自建记录跑满一个月后,拿自己的数据和外部榜单对照:重合的部分可以互相印证;不重合的部分,正是需要追问口径的地方——是问句集不同,还是平台不同,抑或统计周期错位。下表是一个对照思路示例:
| 对照情形 | 说明什么 | 下一步动作 |
|---|---|---|
| 自采与榜单结论一致 | 口径可能接近,可互相印证 | 继续按现有问句集观察趋势 |
| 自采有提及、榜单无 | 榜单问句集可能未覆盖你的场景 | 核对榜单问句来源 |
| 榜单靠前、自采靠后 | 平台或周期差异导致 | 先对齐三要素再比较 |
这里的效果受提问口径、内容信源、平台机制共同影响,按多轮趋势读更可靠。自建记录的价值不在得出一个名次,而在于你手里有了一套可复现、可追问的参照系。
常见问题:读榜前先弄清这几件事
读榜前先弄清三件事:更新频率合不合理、样本量够不够、榜上没自己怎么办。这三件事决定了一张榜单值不值得你花时间。
更新频率多快算合理? 取决于采样方式。人工提问型的榜单,通常按月或按周出;自动化采集可以做到每日更新。频率高不等于结论更准——关键看问句集有没有同步更新。问句集不动、只换名次,说明榜单在重复测同一批问题,参考价值有限。有从业者把问题池做成版本化管理,记录新增与失效问题,再配合多平台采样并记录时间戳,这个思路值得借鉴。
样本量多少才有参考价值? 没有统一门槛。关键看问句集是否覆盖你的业务场景。几十条精准问句,往往比几百条泛词更有用。看榜单时不妨先问:它的问句从哪来、覆盖哪些场景、有没有分层(品牌词、行业词、竞品词)。这些信息缺失,样本量再大也难判断。
榜上没有自己的品牌怎么办? 按顺序排查:其一,确认问句集里有没有与你业务相关的问句;其二,确认平台是否覆盖目标客户常用平台;其三,两项都满足仍不出现,才值得进一步排查内容信源。前两步是口径问题,第三步才是内容问题,顺序反了容易白费力气。
| 读榜疑问 | 先看什么 | 判断依据 |
|---|---|---|
| 更新频率 | 采样方式与问句集版本 | 问句集是否同步更新 |
| 样本量 | 问句覆盖的业务场景 | 精准问句是否分层 |
| 榜上无名 | 问句集、平台覆盖 | 两项满足再查信源 |
AI搜索排名查询工具能帮你省去手工记录的功夫,但工具输出的仍是观测结果,受提问口径、内容信源、平台机制共同影响,按多轮趋势读更可靠。读榜的落脚点,始终是把它当成可追问的参照,而不是结论。
结语
读 AI 搜索排名榜单,动作可以归成四步:先看来源,确认它是人工提问、自动采集还是关注度指数;再对口径,把问句集、平台清单、采样时间三项和自己的业务场景比一遍;然后排误读,不把名次当真实排序,不跨口径拼数字,不把热度当质量;最后自建记录,用十几条精准问句在固定平台上按周采样,跑出基线再去校验外部榜单。这套方法不保证你看到的每份榜单都可靠,但能让你在看不懂来源时及时收手,在看懂口径时把榜单用成参考。榜单是别人某一时刻的观测快照,你自己的记录才是能持续对照的那把尺。
本文部分配图由 AI 生成。
常见问题
AI搜索排名榜单的数据来源一般有哪些,哪种更可信?
常见来源有三类:人工按问句集逐条提问记录、爬虫或接口批量采集、用户点击或投票形成的关注度指数。三类没有绝对的可信高低,要看用途。想了解目标客户真实提问下品牌被提及的情况,人工提问采样更贴近场景;想做高频监控,自动化采集更合适,但要留意页面改版和限流对数据连续性的影响;关注度类指数反映的是热度,不适合拿来判断答案质量。读榜时先看它写没写采集方式、平台清单和采样时间,三项齐全的参考权重更高。
同一家公司,两份AI搜索排名榜单名次差很多,该信哪个?
先别急着选边,两份榜单名次不同,多半是口径不同。对照三件事:问句集是否一样,平台清单是否重合,采样时间是否接近。问句集里品牌词和场景长句的比例不同,提及率就会差很多;平台不同,答案来源和呈现方式也不一样;采样时间隔得久,AI 回答本身就有波动。三项对齐后仍有明显差距,再看各自的样本量和统计方式。实际操作中,更稳妥的做法是用自己的问句集跑一份记录,拿它去校验两份榜单,重合部分互相印证,不重合部分追问口径。
不想买工具,自己能记录AI搜索排名吗?
可以,起步阶段用表格就够。先定 10 到 20 条和自己业务直接相关的问句,覆盖品牌词、品类词和场景长句,固定 2 到 3 个目标客户常用的平台,按周或按双周采样。每条记录写清提问日期、平台、问句原文、品牌是否被提及、提及位置、引用来源和回答摘要。问句集定版后不要随意改动,新增问句单独标记,避免新旧数据混在一起比较。跑满一个月,你就有了一份自己的基线,再拿外部榜单对照,判断哪些结论和自己的观测一致。
把阅读中的方法用到您的品牌
从提问词和平台专属写手开始,组织品牌内容与后续监测。
免费注册