GEO技术实现原理是什么:从查询理解到答案生成的五段链路拆解
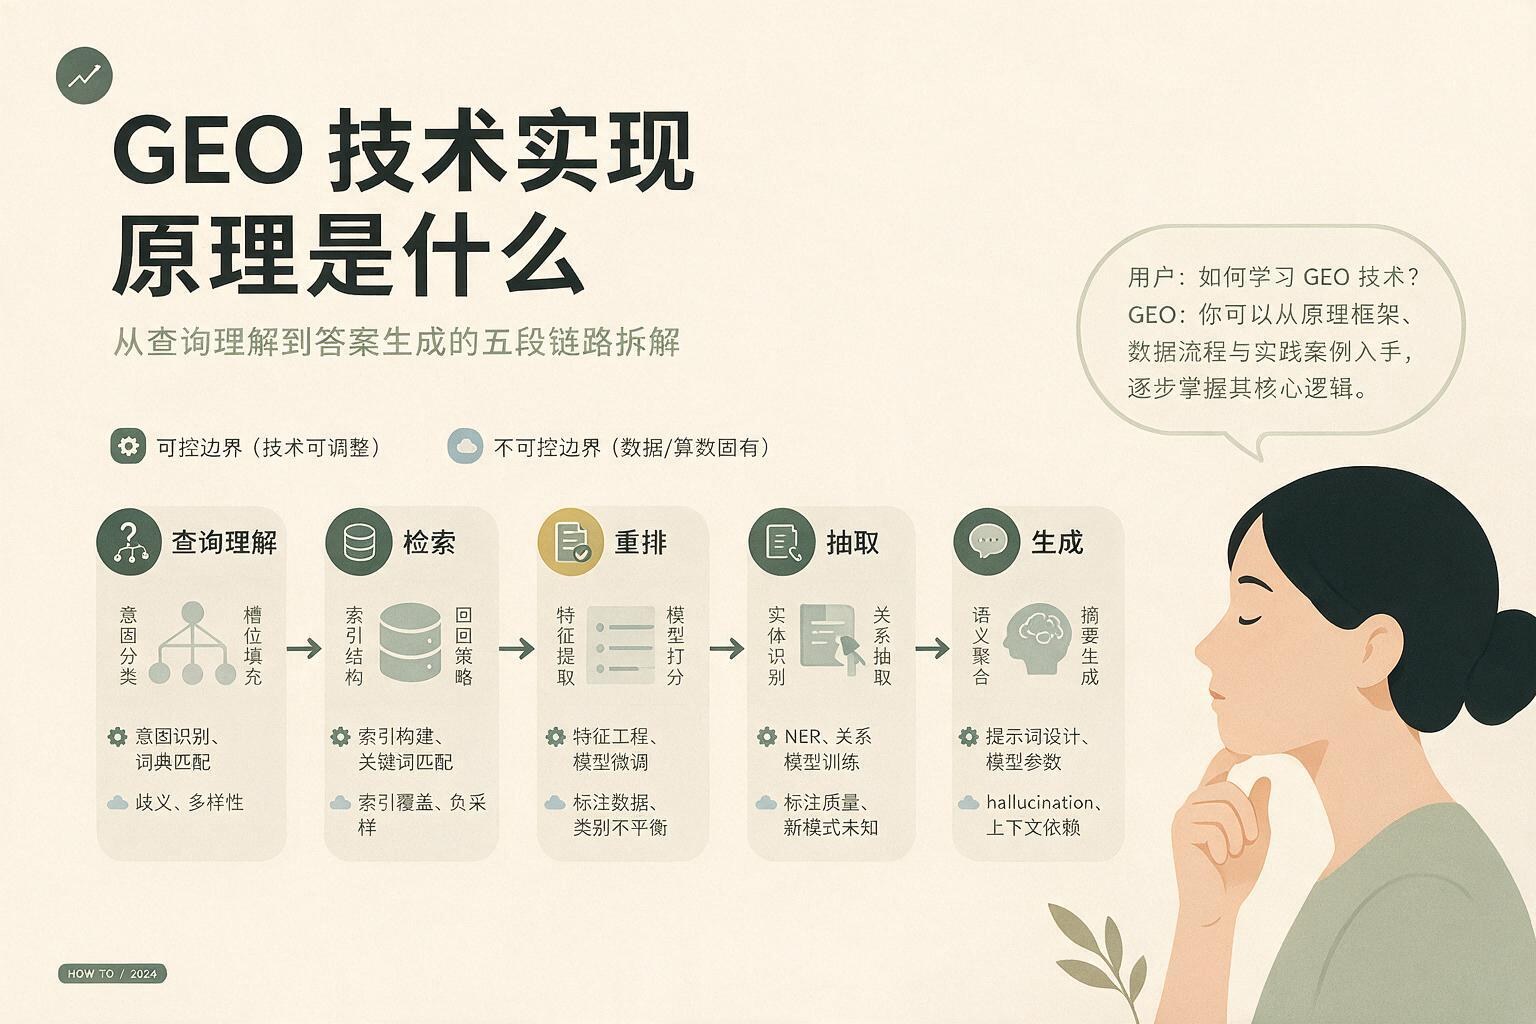
要点:GEO的技术链路可以拆成五段:查询理解、检索与召回、重排、切片与段落粒度、引用选择与生成。用户敲下一句提问,系统先把它改写成可检索的表达,再去索引里捞出一批候选,重排把候选压成少量高相关上下文,最后模型在这段上下文里挑句子、标来源、组织答案。本文涉及GEO的完整技术链路包含哪几个阶段、查询理解阶段做了什么改写、检索与召回阶段如何决定候选池。
- GEO的技术链路可以拆成五段:查询理解、检索与召回、重排、切片与段落粒度、引用选择与生成。
- 查询理解阶段的核心动作,是把用户那句口语化、带指代、可能夹着多个意图的问句,转写成检索器能直接匹配的独立查询。
- 检索与召回阶段的任务,是从索引里先捞出一批可能相关的片段,形成候选池交给重排。
- 引用机制要落地的核心,是让每一句答案都能回到原文的某个具体位置。
GEO(生成式引擎优化)的技术实现原理,本质上是把一条检索增强生成(RAG)链路拆开看:查询理解 → 检索与召回 → 重排 → 切片与段落粒度 → 引用选择与生成。生成式引擎先把你
GEO(生成式引擎优化)的技术实现原理,本质上是把一条检索增强生成(RAG)链路拆开看:查询理解 → 检索与召回 → 重排 → 切片与段落粒度 → 引用选择与生成。生成式引擎先把你输入的问题改写成可检索的形式,从索引里召回一批候选段落,再用重排模型按相关性精排,最后从高分段落中抽取证据、组织成带引用的答案。对工程师来说,关键不是记住名词,而是分清哪一段可以调、哪一段受平台机制约束。本文按这条链路逐段说明机制与优化点,并给出一份可落地的工程检查清单。
GEO的完整技术链路包含哪几个阶段
GEO的技术链路可以拆成五段:查询理解、检索与召回、重排、切片与段落粒度、引用选择与生成。用户敲下一句提问,系统先把它改写成可检索的表达,再去索引里捞出一批候选,重排把候选压成少量高相关上下文,最后模型在这段上下文里挑句子、标来源、组织答案。公开技术资料对生成式检索链路的拆解也基本落在这个框架上,检索、重排、引用选择、生成与标注是常被并列讨论的阶段 。
把每段的输入输出写清楚,链路就不抽象了:
| 阶段 | 输入 | 输出 |
|---|---|---|
| 查询理解 | 用户原始提问、对话历史 | 改写后的检索式、子问题列表 |
| 检索与召回 | 检索式、向量索引与倒排索引 | Top-K 候选片段 |
| 重排 | Top-K 候选、查询 | 精排后的少量上下文 |
| 切片与段落粒度 | 原始文档 | 可被召回的 chunk 单元 |
| 引用选择与生成 | 精排上下文、提示模板 | 带来源标注的答案 |
这张表里有个容易被忽略的点:切片并不是在线阶段才发生的动作。文档入库时就要切好、向量化、建索引,这条离线路径决定了在线检索能捞到什么。在线路径只负责把查询送进去、把候选捞出来、把上下文拼好交给模型。两条路径共用同一套 chunk 定义,离线切得粗,在线重排再精细也补不回丢失的语义。有公开实测显示,chunk 大小与重叠比例的调整会让检索命中率出现明显差异,256 与 512 两档在约 800 份混合格式文档上的命中率@5 分别为 61% 与 71% ,说明粒度选择直接影响下游可用的候选质量。
工程上按阶段定位问题,比笼统说“效果不好”有用得多。答案答偏了,先看是召回没捞到正确段落,还是捞到了但重排把它排到后面,还是上下文里明明有依据、模型却没引用。这三类故障对应的修法完全不同:召回问题回去调切片与混合检索,排序问题换交叉编码器重排,生成问题改提示模板与引用约束。公开资料里把重排单列为链路关键一环,也是因为向量召回容易把语义相近但主题无关的文档带进来,需要精排再筛一遍 。把链路画成图、给每段标上可观测指标,排查才有落点。
查询理解阶段做了什么改写
查询理解阶段的核心动作,是把用户那句口语化、带指代、可能夹着多个意图的问句,转写成检索器能直接匹配的独立查询。用户问“这个和上一个比哪个更稳”,系统得先判断“这个”指谁、“上一个”是哪款,再把整句压缩成一条不依赖上下文也能检索的短查询。这一步做不好,后面召回再强也捞不到对的东西。
具体拆开看,主要有三种改写手法。其一,指代补全与上下文压缩:把多轮对话里的省略成分还原成实体名,把长句里修饰性成分剥掉,只留检索意图。其二,子问题拆解:一个问题里实际包含“价格多少”“支持哪些格式”两件事时,拆成两条查询并行检索,再合并候选。公开资料里也提到,生成侧要把复杂问题拆成可检索的子问题,多路并行检索以提升效率 。其三,HyDE 一类做法:先让模型生成一段假设答案,再用这段假设答案去检索。它适合问题短、文档长、字面词对不上的场景,比如用几个字去搜整段技术文档,模态不匹配会拖累召回 ;代价是多一次生成调用,且假设答案跑偏会把检索带偏,所以通常只在召回质量差时启用。
这里要分清可控与不可控。内容侧能影响的是表述清晰度与实体明确度:标题里写全产品名、正文里把“它”“该方案”换成具体对象、一段只讲一件事,这些都会让改写后的查询更容易命中。改写策略本身由平台决定——用不用 HyDE、拆几个子问题、指代怎么补,这些参数不在内容方手里。工程上可以做的是把内容写成“自带上下文”的形态,降低平台改写的难度。
| 改写动作 | 触发条件 | 内容侧可配合的点 |
|---|---|---|
| 指代补全 | 多轮对话、省略主语 | 段落内实体名写全,少用代词 |
| 子问题拆解 | 单句含多个意图 | 一段只回答一个问题 |
| HyDE 假设答案 | 短查询对长文档 | 标题与首句点明主题词 |
把这三类改写认清楚,排查时就能判断:是内容表述太模糊导致改写跑偏,还是平台策略本身没覆盖这类问法。前者能改,后者只能靠内容形态去适配。
检索与召回阶段如何决定候选池
检索与召回阶段的任务,是从索引里先捞出一批可能相关的片段,形成候选池交给重排。候选池的质量决定后面几步的上限:池子里没有正确答案,重排再准也救不回来。
向量检索和关键词检索各有短板。向量检索擅长语义相近,问“怎么让答案被引用”和文档里写“提升引用概率”能对上;但它对型号、编号、专有名词这类精确串不敏感,容易召回主题相近却答非所问的段落 。关键词检索(如 BM25)擅长精确匹配,术语、报错码、产品名一打一个准,可换个说法就召不回来。
工程上常见做法是混合检索:两路各自召回,再按排名融合去重。公开的伪代码里能看到 k=10 这类写法,即两路结果合并后取前若干条送重排 。融合方式一般按排名而非原始分数,因为两路分数量纲不同,直接加权容易失真。
| 检索方式 | 擅长 | 短板 | 适用场景 |
|---|---|---|---|
| 向量检索 | 语义相近、同义改写 | 精确串、编号易漂移 | 概念解释、问答类 |
| 关键词检索 | 术语、型号、报错码 | 换说法召不回 | 技术文档、参数查询 |
| 混合检索 | 兼顾两类 | 需去重与融合调参 | 多数生产链路 |
召回数量 K 是个取舍。K 太小,漏召回,正确段落压根没进池子;K 太大,重排负担上升,噪声片段也会挤占上下文。常见做法是召回阶段放宽、重排阶段收紧,把精度问题交给后一步 。
索引侧同样影响召回。向量化模型选得对不对,直接决定语义空间里“近不近”;索引结构上,FAISS、pgvector 这类方案在数据规模和查询延迟上各有取舍,公开实现里常把向量索引与重排分开部署 。切片粒度也会牵动命中率,块太大语义被稀释,块太小上下文被切碎,有实测显示不同粒度下命中率存在明显差距 。
可控边界要说清楚:一段内容能不能被召回,取决于它是否进了索引、切分是否完整、表述是否带足上下文;而检索参数、K 值、融合权重掌握在平台侧,内容方改不了。所以排查时先看索引收录与切分质量,再看表述能否被两种检索同时命中,把能改的先改到位。
重排机制为什么能提升相关性
重排之所以能提升相关性,是因为它换了一种打分方式:不再让查询和候选各自算向量再比距离,而是把查询与候选段落拼在一起送进交叉编码器(cross-encoder),逐对判断“这段文字能不能回答这个问题”。向量召回用的是双塔结构,查询和文档在编码时互不可见,语义相近但不是同一个意图的段落容易被误召回;交叉编码器让两者在模型内部直接交互,判断更贴近真实相关性,代价是每对候选都要跑一次前向,算力开销随候选数量线性上涨,因此只适合放在精排阶段 。
典型链路可以拆成三步:召回先取 Top-K,重排从中挑出 Top-N,再把 N 段拼成上下文交给生成侧 。公开实现里常见的是向量检索与关键词检索各取一批、按排名融合去重,再交给 cross-encoder 排序,例如代码示例中先合并多路结果,再用重排模型对前 10 条重新打分,最后拼接上下文 。K 与 N 的取值决定了成本与精度的平衡点,K 太大重排延迟上升,N 太小上下文不够用。
| 环节 | 打分方式 | 精度 | 成本 | 作用位置 |
|---|---|---|---|---|
| 向量召回 | 双塔各自编码后算相似度 | 语义近似,主题易偏 | 低,可预先建索引 | 召回 Top-K |
| 关键词召回 | 词项匹配(如 BM25) | 字面命中强,语义弱 | 低 | 与向量结果融合 |
| 重排 | 查询与候选逐对交叉编码 | 相关性判断更准 | 高,逐对前向 | 精排取 Top-N |
中文场景的适配要单独考虑。有实践选用面向中文训练的重排模型(如 BAAI/bge-reranker-large)替代通用英文模型,理由是中文查询与段落的语义对齐在英文模型上会打折扣 。部署上有两条路:调用托管 API,省去运维但按调用量计费、数据要出域;本地部署开源模型,成本可控、可内网运行,但要自己承担显存与并发。选哪条取决于检索量和数据合规要求,没有统一答案。
可控边界在这里比较清楚。重排模型由平台选型,权重、阈值、Top-N 都握在检索侧,内容方改不了这些参数。内容侧能做的是让每个段落主题集中、一段只回答一个问题,并在段首把核心结论写出来,这样交叉编码器拿到的候选片段本身信息密度高,逐对打分时更容易被判为相关。反过来,一段里混了三四个话题,重排模型很难判断它到底对应哪个意图,分数会被拉低。
还有一点常被忽略:重排的输入是召回结果,召回没进来的段落,重排再准也救不回来。所以排查相关性时先看召回阶段有没有漏,再看重排分数是否合理,顺序反了会白费功夫。
切片与段落粒度如何影响抽取命中率
切片粒度直接决定抽取命中率:块切得太碎,一个完整语义被拆成几段,每段信息量不足;块切得太大,向量里混进多个话题,相似度检索的区分度下降。两头的命中率都低,中间一段偏高,曲线整体呈倒 U 型。
公开实测数据可以说明这个形状。据 SegmentFault 上一篇 RAG 落地实录,在约 800 份 PDF 与 Markdown 混合的内部文档上,chunk_size=256、overlap=0 时命中率@5 为 61%,512/50 为 71%,512/128 为 79% 。该文同时提醒,网上教程常见的 512/50 默认值只是中规中矩,直接照抄未必合适。另一组实测把粒度继续往上推:600 左右处于较优区间,800 与 600 接近,1000 开始稀释,1500 时命中率回落到与小分块相近的水平 。
| chunk_size | overlap | 命中率@5 | 观察 |
|---|---|---|---|
| 256 | 0 | 61% | 语义被切碎,单块信息不足 |
| 512 | 50 | 71% | 常见默认值,表现居中 |
| 512 | 128 | 79% | 同粒度下加大重叠,命中提升 |
| 约 600 | — | 处于较优区间 | 该组实测的偏高段 |
| 约 1500 | — | 命中回落 | 一块塞进多个话题,稀释明显 |
overlap 不是越大越好。据同一组实测,重叠比例超过约 15% 之后收益趋近于零,继续加只会多出冗余块,抬高存储与向量化成本,检索精度不再变化 。所以调参时先定 chunk_size,再用小步长试 overlap,到收益走平就停。
可复现的调参方法大致是这样:其一,从自己的知识库里抽几十个真实问题,人工标注每个问题对应的正确段落,构成评测集,数据不同结论就不同 ;其二,以 256、512、800、1200 为候选粒度各跑一遍,记录命中率@5,画出自己文档上的曲线;其三,在表现较好的粒度附近以 64 为步长细调,再固定粒度扫 overlap;其四,按文档类型分组看结果,技术文档、FAQ、长报告适合的粒度往往不同。
还有一点要落在写作侧:粒度参数由检索侧掌握,内容方能做的是让每个段落主题集中、段首写清结论,这样无论切到哪一档,切出来的块都不至于语义残缺。参数调优和段落组织是两件事,但都影响同一项命中率。
引用选择与置信机制怎么落地
引用机制要落地的核心,是让每一句答案都能回到原文的某个具体位置。工程上通常给每个片段绑定文档ID、段落位置和版本号,形成可回溯的引用锚点;同一内容被多次召回时,按锚点去重,避免同一段落在上下文里重复出现 。这样做的好处很直接:答案里出现争议时,能定位到对应版本的那一段,而不是只给一个文档名。
置信度过滤则发生在送入生成之前。检索或重排给出的相关性得分高于阈值的片段才进入上下文,低于阈值的无关片段被过滤掉 。大模型从文档中萃取的节点同样带置信度,低置信节点标记为待审核,而不是直接当作事实使用 。阈值定在哪里,取决于业务对漏召和误召的容忍度,需要用自己的评测集去扫。
提示词约束是防编造的另一道闸。常见写法是明确要求:上下文未包含回答该问题所需的信息时,直接回复“根据现有文档未查询到相关内容”,不自行发挥 。这条约束要和结构化输出配合。要求模型在答案后输出 Sources 字段,例如 [{"id": 1, "doc": "...", "page": 15}],前端据此还原引用来源,用户点开就能看到出处 。
落地时可以用一张验收表把这几件事固定下来:
| 检查项 | 可核对的内容 | 不通过时的表现 |
|---|---|---|
| 引用锚点 | 每条引用含文档ID、段落位置、版本 | 只能给文档名,无法定位段落 |
| 置信过滤 | 低于阈值的片段未进入上下文 | 无关段落混入,答案跑题 |
| 拒答约束 | 无答案时明确回复未查询到 | 模型自行补全,出现编造 |
| Sources 输出 | 结构化字段可被前端解析 | 引用与正文对不上 |
还有一点要放在验收口径里:同一套机制在不同提问口径和平台机制下表现会有差异,单次结果波动大,按多轮趋势读更可靠。检查清单的价值不在于一次跑分,而在于每次改检索或改提示词后,能快速确认引用是否还对得上、拒答是否还守得住。
结语
把GEO技术实现原理落到工程上,可以按这份清单推进:一、先画出自己内容在五段链路中的位置,明确哪段是平台侧、哪段是内容侧;二、用真实问题构造评测集,跑recall@k建立基线;三、按文档类型调chunk_size与overlap,记录命中率变化而不是照抄默认值;四、检查段落是否主题集中、实体明确,能被单独切片理解;五、为引用锚点绑定文档ID、段落位置与版本,保证答案可回溯;六、在提示词层约束无答案时不发挥,并用结构化Sources输出便于前端还原。链路里能调的部分集中在内容组织与索引质量,检索参数与重排模型由平台掌握,按多轮趋势读效果更可靠。
本文部分配图由 AI 生成。
常见问题
GEO和传统SEO在技术原理上有什么不同?
传统SEO优化的是网页在结果列表中的排序,核心是链接与页面权重;GEO优化的是内容能否被生成式引擎的RAG链路召回、重排并抽取为答案证据。链路多了查询改写、重排和引用选择几段,所以内容侧的重点从关键词密度转向段落主题集中、实体明确、可被切片后独立理解。两者不冲突,但可优化的抓手不同。
分块大小到底设多少合适?有没有通用值?
没有通用值。公开实测里,约800份混合文档下512/50的命中率@5为71%,512/128为79%,而256/0只有61%;另一组实测显示600左右处于较优区间,1500时明显回落。结论是精度曲线呈倒U型,要按自己的文档类型、embedding模型和评测集调。做法是抽50个真实问题人工标注,跑recall@k对比几组参数再定。
重排环节是必须的吗,能不能省掉?
不是必须,但省掉通常要付出相关性代价。只靠向量相似度召回,常出现语义相近但主题无关的段落被误召回;重排用交叉编码器逐对打分,能把真正对题的段落提到前面。代价是延迟和成本增加,所以常见做法是召回取较大K,重排只处理Top-K再取Top-N。是否启用取决于你对答案精度和响应时延的取舍。
把阅读中的方法用到您的品牌
从提问词和平台专属写手开始,组织品牌内容与后续监测。
免费注册